Kontext
Ich wollte prüfen, warum doppelt so viele Rechenressourcen nicht automatisch halbe Laufzeit bedeuten. Dafür baute ich einen wiederholbaren Benchmark mit einsehbaren Rohdaten.
Ansatz
Ich teile die Mittelpunktregel-Berechnung in unabhängige Bereiche. Worker-Prozesse bilden Teilsummen, der Hauptprozess addiert sie. Gemessen werden die End-to-End-ProcessPool-Zeit gegen eigene sequentielle Referenzen und der Peak-RSS.
System
- Mittelpunktregel für π: 4 / (1 + x²) auf [0, 1].
- Reine Python-Schleife ohne NumPy; Prozesse liefern Teilsummen.
- ProcessPoolExecutor mit 1, 2, 4, 6, 8 oder 12 Workern; fünf Wiederholungen, Median plus Minimum und Maximum.
- Feste N im Strong Scaling, kalibrierte Größen im separaten Block; End-to-End-Wandzeit und Peak-RSS.
- Numerische Methode
- Worker-Prozesse
- Task-Verteilung
- Reduktion
- Messauswertung
Technische Entscheidungen
- Deterministische Integration statt Monte Carlo.
- Prozesse statt Threads für die CPU-lastige Python-Schleife; kein Thread-Vergleich.
- Separate sequentielle Baselines; Median und Min/Max aus fünf Wiederholungen.
Was nicht funktioniert hat
Ein CPU-lastiger Algorithmus auf einem System samt Scheduler; keine CPU-Affinität. RSS kann geteilte Seiten doppelt zählen. P × T_P ist keine Energie- oder CPU-Zeitmessung; getrennte Läufe können schwanken.
Ergebnis
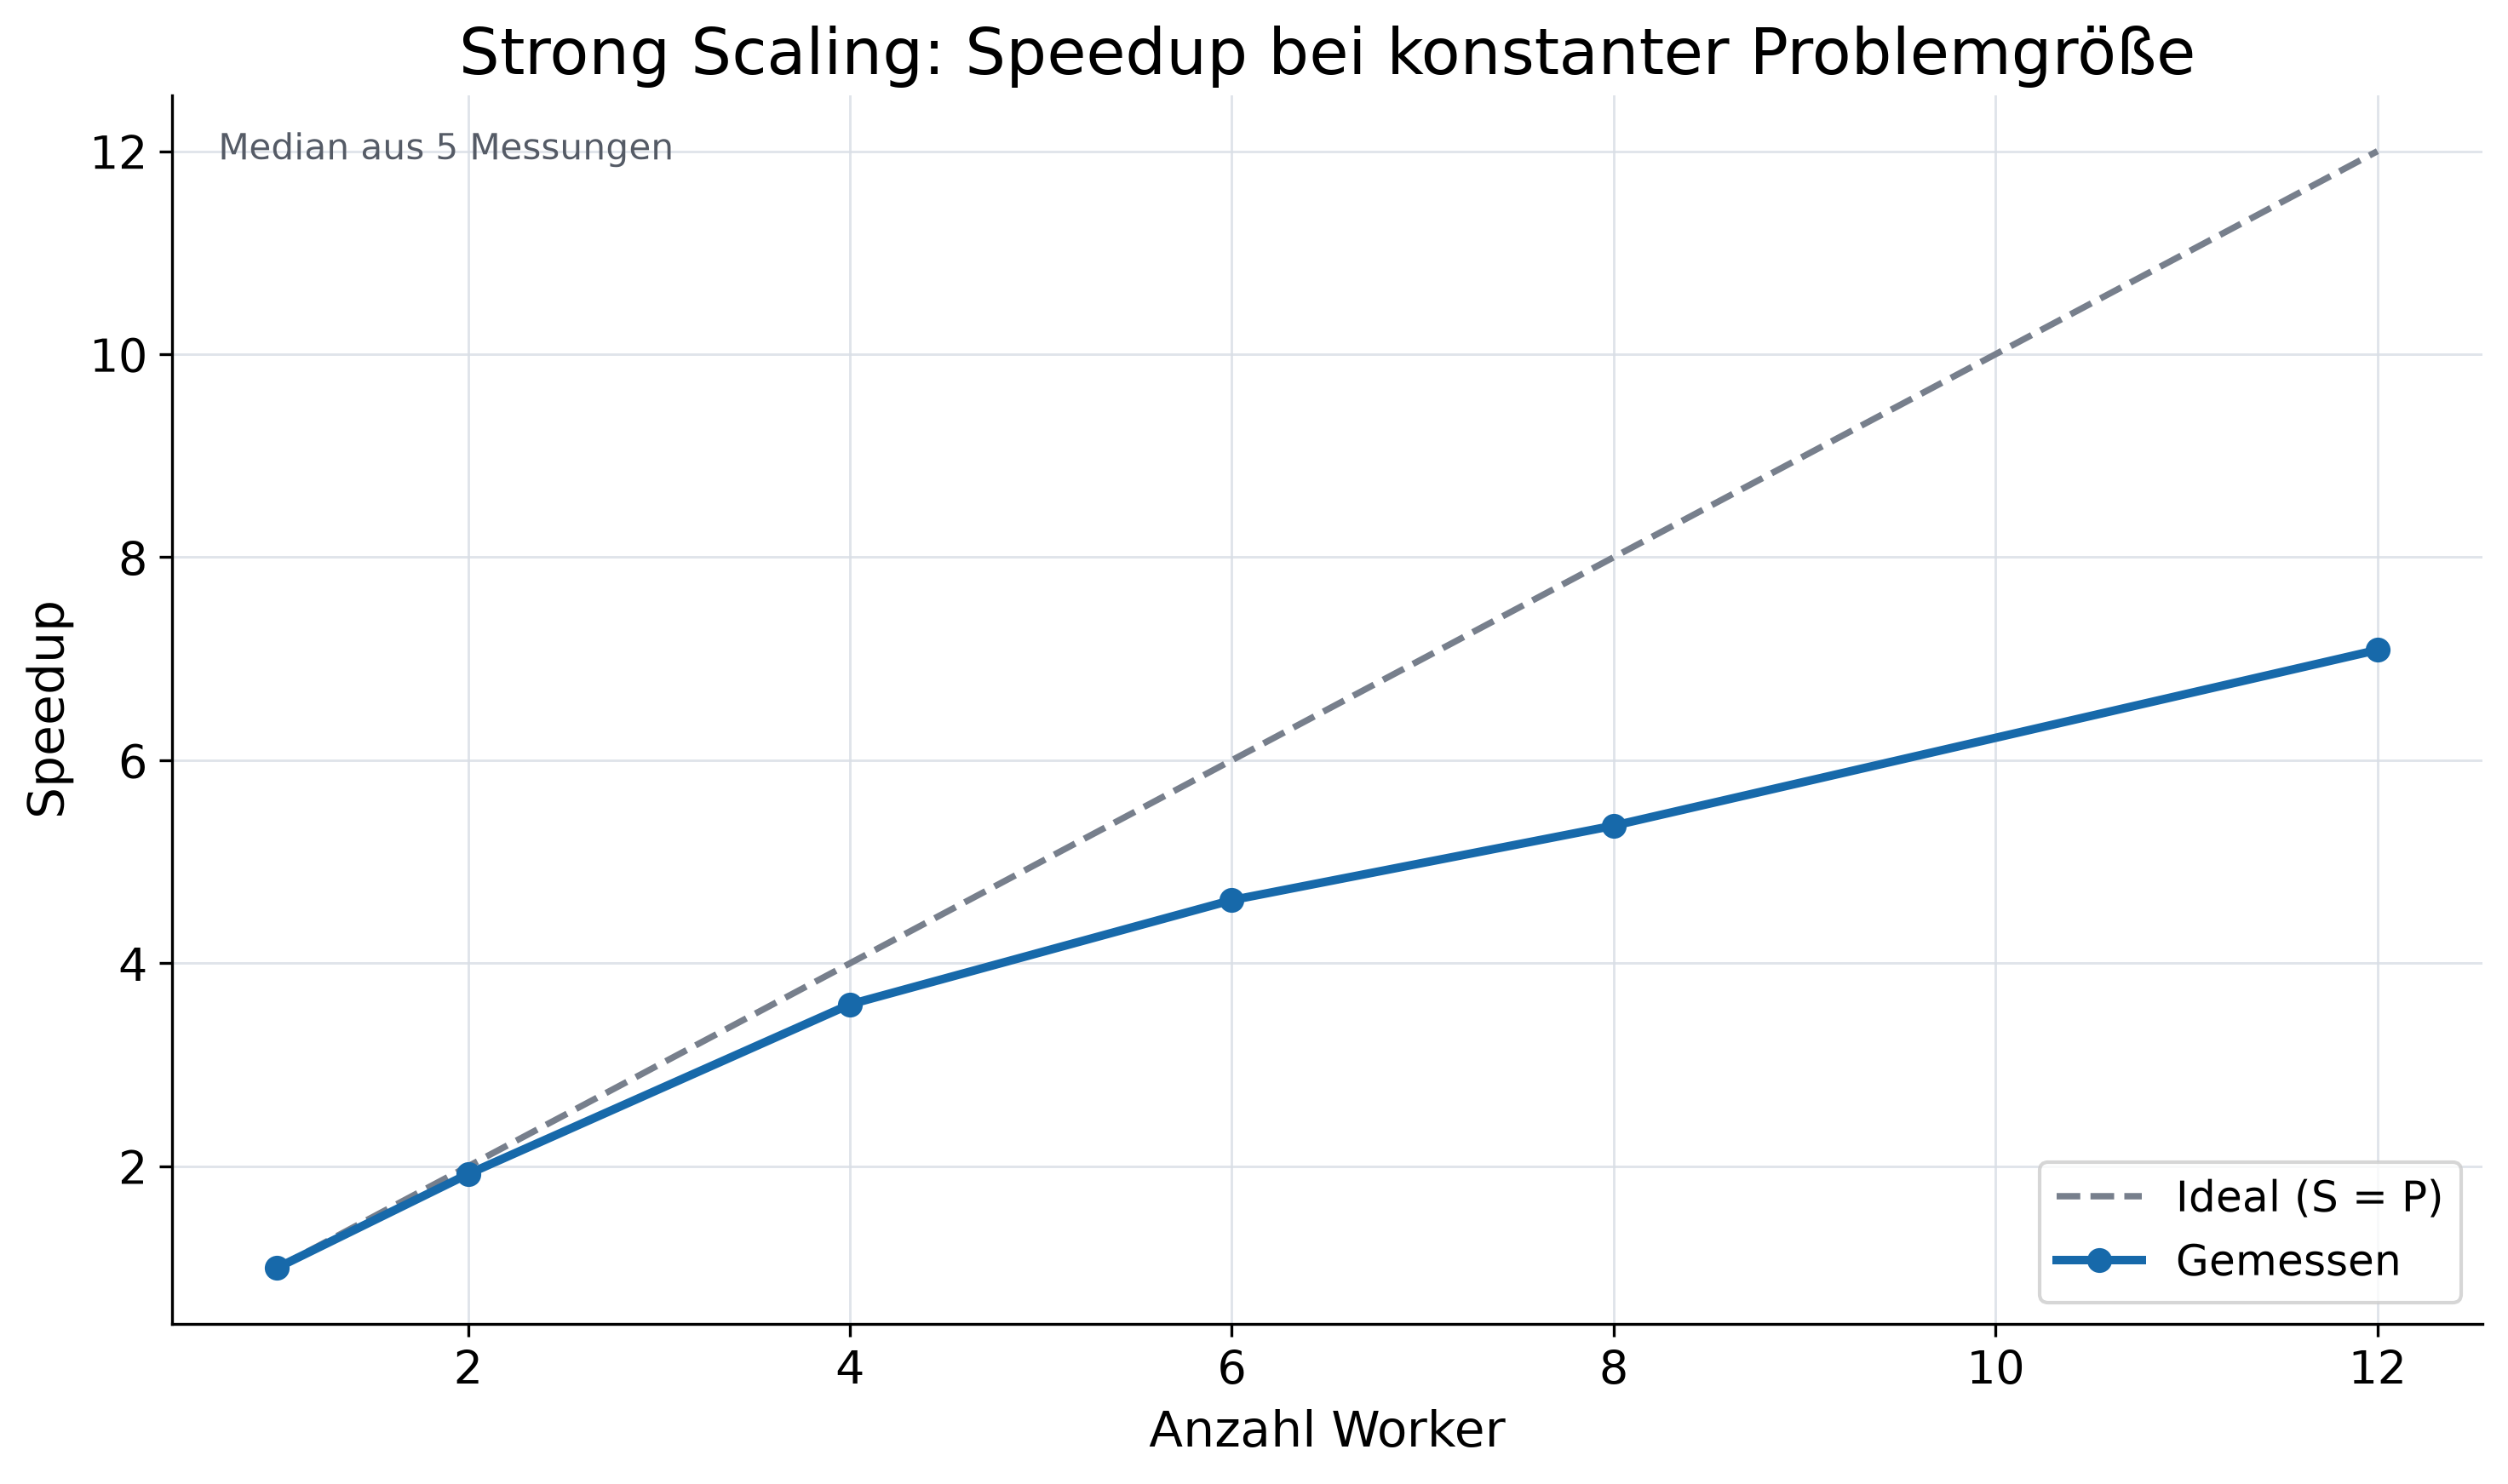
Strong-Scaling-Large: 4,056 s sequentiell, 0,572 s mit zwölf Prozessen (Speedup 7,09; rund 59 % Effizienz). P × T_P steigt von 4,06 auf 6,87 Prozessor-Sekunden. Im separaten Größenblock wächst Peak-RSS von rund 70 auf 299 MB.
Was ich mitgenommen habe
Parallelisierung beschleunigt die Rechnung, aber Speedup, Effizienz und Speicher entwickeln sich nicht proportional. Sinnvolle Parallelität hängt davon ab, ob der Zeitgewinn Verwaltung, Speicher und zusätzliche Ressourcen rechtfertigt.
Mein Beitrag
Das Repository enthält den Benchmark-Code, die verwendeten Konfigurationen, Rohdaten, zusammengefasste Ergebnisse und die daraus erzeugten Diagramme. Die Messwerte im Text stammen aus dem Full-Run vom 26. September 2026.
Die Frage hinter dem Versuch
Wenn zwei Personen eine Aufgabe halbieren, stellen wir uns oft vor, dass sie ungefähr doppelt so schnell fertig werden. Bei Prozessoren liegt derselbe Gedanke nahe: Warum nicht immer mehr Kerne einbauen und jede Berechnung auf mehr Schultern verteilen?
Mich interessierte nicht nur, ob paralleler Code schneller ist. Ich wollte sehen, was zwischen dem Aufteilen der Arbeit und dem fertigen Ergebnis passiert – und ob der zusätzliche Aufwand in den Zahlen sichtbar wird. Dafür brauchte ich eine Aufgabe, die sich gut teilen lässt und deren Ergebnis ich kontrollieren kann.
Parallel arbeiten heißt auch zusammenführen
Ein sequentieller Algorithmus erledigt seine Schritte nacheinander. Ein paralleler Algorithmus verteilt unabhängige Teilaufgaben auf mehrere Recheneinheiten. Bei einer Summe lassen sich etwa (a + b) und (c + d) gleichzeitig berechnen; erst danach werden die beiden Teilergebnisse addiert. Diese abschließende Zusammenführung heißt Reduktion. Sie ist einfach, aber sie verschwindet nicht, nur weil vorher parallel gerechnet wurde.
Genau darin steckt der erste Trade-off: Ein Teil der Arbeit kann gleichzeitig stattfinden, andere Schritte bleiben abhängig oder müssen koordiniert werden. In der Vorlesung zu parallelen Algorithmen wird diese Frage an Problemen wie Summen und Präfixsummen sichtbar.[3] Für mein Experiment war die Summe nützlich, weil jeder Worker einen disjunkten Bereich bearbeiten und eine einzelne Teilsumme zurückgeben konnte.
Was ich überhaupt messe
Die Laufzeit T sagt zunächst nur, wie lange eine Berechnung braucht. Der Speedup setzt die direkte sequentielle Laufzeit T_seq zur parallelen Zeit T_P ins Verhältnis: S = T_seq / T_P. Werden aus acht Sekunden zwei, ist S = 4. Das heißt: Die getestete Variante erledigt dieselbe Aufgabe in einem Viertel der Wandzeit.
Die Effizienz setzt diesen Speedup wiederum ins Verhältnis zu P, der Zahl der Worker-Prozesse: E = S / P. Sie beantwortet nicht, wie hoch die CPU-Auslastung war. Sie sagt, wie viel Beschleunigung ich pro eingesetztem Prozess erhalten habe. Ein effizienter Wert ist also eine Bewertung des Skalierens, kein Auslastungsmesser.
Für parallele Kosten verwende ich P × T_P. Damit lässt sich ausdrücken, wie viele Prozessor-Sekunden das einfache Modell für P gleichzeitig bereitgestellte Recheneinheiten und die Laufzeit T_P ansetzt. Verwaltung, Scheduling, Kommunikation, Ergebnisübertragung und Reduktion bilden Overhead. Der Speicherbedarf ist eine weitere eigene Größe: Ein Lauf kann schneller sein und gleichzeitig mehr RAM beanspruchen.
Warum ich π berechnet habe
Ich habe eine numerische Integration gewählt, keine Monte-Carlo-Methode. Der mathematische Ausgangspunkt ist ∫₀¹ 4 / (1 + x²) dx = π: Die Stammfunktion von 1 / (1 + x²) ist arctan(x); zwischen 0 und 1 ergibt das π/4, mit dem Faktor 4 also π.[1]
Für die Mittelpunktregel teile ich das Intervall [0, 1] in N gleich große Abschnitte. Für jeden Abschnitt werte ich die Funktion in der Mitte aus, multipliziere die Summe der Funktionswerte mit der Abschnittsbreite und erhalte eine Näherung. In der Implementierung berechnet eine Schleife jeweils einen x-Wert und addiert den Beitrag direkt zur lokalen Summe – es wird kein Array mit Millionen Zwischenwerten angelegt.
Die Abschnitte sind voneinander unabhängig. So kann ich N in zusammenhängende Bereiche zerlegen, jeden Bereich separat berechnen lassen und die Teilsummen am Ende addieren. Die mathematische Aufgabe bleibt dieselbe; nur die Reihenfolge und Anzahl der gleichzeitig ausgeführten Schritte ändert sich.
Der Aufbau des Benchmarks
Der Benchmark ist in Python geschrieben. Die numerische Kernberechnung ist eine reine Python-Schleife, ohne NumPy-Vektorisierung. Für parallele Varianten nutze ich `concurrent.futures.ProcessPoolExecutor`: Er führt Aufgaben in separaten Prozessen aus; Python dokumentiert diese Prozess-Pool-Schnittstelle als Teil von `concurrent.futures`.[2] Ich habe Prozesse und keine normalen Python-Threads verglichen – ein Thread-Vergleich war nicht Teil dieses Experiments.
Ich teste 1, 2, 4, 6, 8 und 12 Prozesse. Jede Konfiguration wird fünfmal ausgeführt. Als Hauptwert dient der Median; Minimum und Maximum bilden den beobachteten Fehlerbereich in den Laufzeitdiagrammen. Die gemessene ProcessPool-Zeit ist End-to-End: Sie umfasst Prozessverwaltung, Verteilung, Berechnung, Rückgabe der Ergebnisse, Reduktion und Pool-Abbau. Das ist bewusst mehr als nur die Zeit in der inneren Rechenschleife.
Für den Speicher beobachtet `psutil` ungefähr alle 15 Millisekunden den RSS des Hauptprozesses und seiner Kindprozesse. RSS steht hier für den residenten Speicher, den das Betriebssystem einem Prozess zuordnet. Es ist eine Näherung, keine exakte Rechnung exklusiv belegter physischer RAM-Seiten.
Drei Problemgrößen, zwei Messreihen
Small, Medium und Large sind nicht bloß Etiketten. Der Full-Run kalibriert N automatisch anhand sequentieller Zielzeiten. Heraus kamen 3.771.022 Intervalle für Small, 18.997.300 für Medium und 75.392.548 für Large. Die dazugehörigen sequentiellen Medianzeiten im Problemgrößenexperiment lagen bei ungefähr 0,234 s, 1,170 s und 4,763 s.
Wichtig ist, die Large-Referenz aus diesem Block nicht mit Strong Scaling zu vermischen. Dort wurde eine eigene sequentielle Baseline von 4,056 s gemessen. Die Problemgrößenreihe und die Strong-Scaling-Reihe sind separate Messblöcke; jede hat ihre eigene Referenzzeit. Auch fünf Wiederholungen und ein Median machen Messungen nicht unveränderlich: Hintergrundlast, Temperatur und Scheduler können zwischen Läufen Unterschiede erzeugen.
Ergebnis 1: deutlich schneller, aber nicht zwölfmal
Für Strong Scaling bleibt N konstant bei 75.392.548. Die direkte sequentielle Referenz liegt bei 4,056 s. Mit zwei Worker-Prozessen fällt die Medianzeit auf 2,108 s (Speedup 1,92), mit vier auf 1,128 s (3,60), mit sechs auf 0,877 s (4,62), mit acht auf 0,757 s (5,36) und mit zwölf auf 0,572 s (7,09).
Zwölf Prozesse beschleunigen die Berechnung also merklich. Aber die Kurve läuft nicht bis zur idealen zwölf. Die gestrichelte Linie im Diagramm zeigt S = P: Sie wäre der Fall, in dem sich der Speedup genau proportional zur Prozesszahl verhält. Die Messkurve bleibt darunter. Der Abstand ist keine Überraschung, sondern der sichtbare Platz für nicht parallelisierte Arbeit und Kosten des Parallelisierens.
Ergebnis 2: die Effizienz nimmt ab
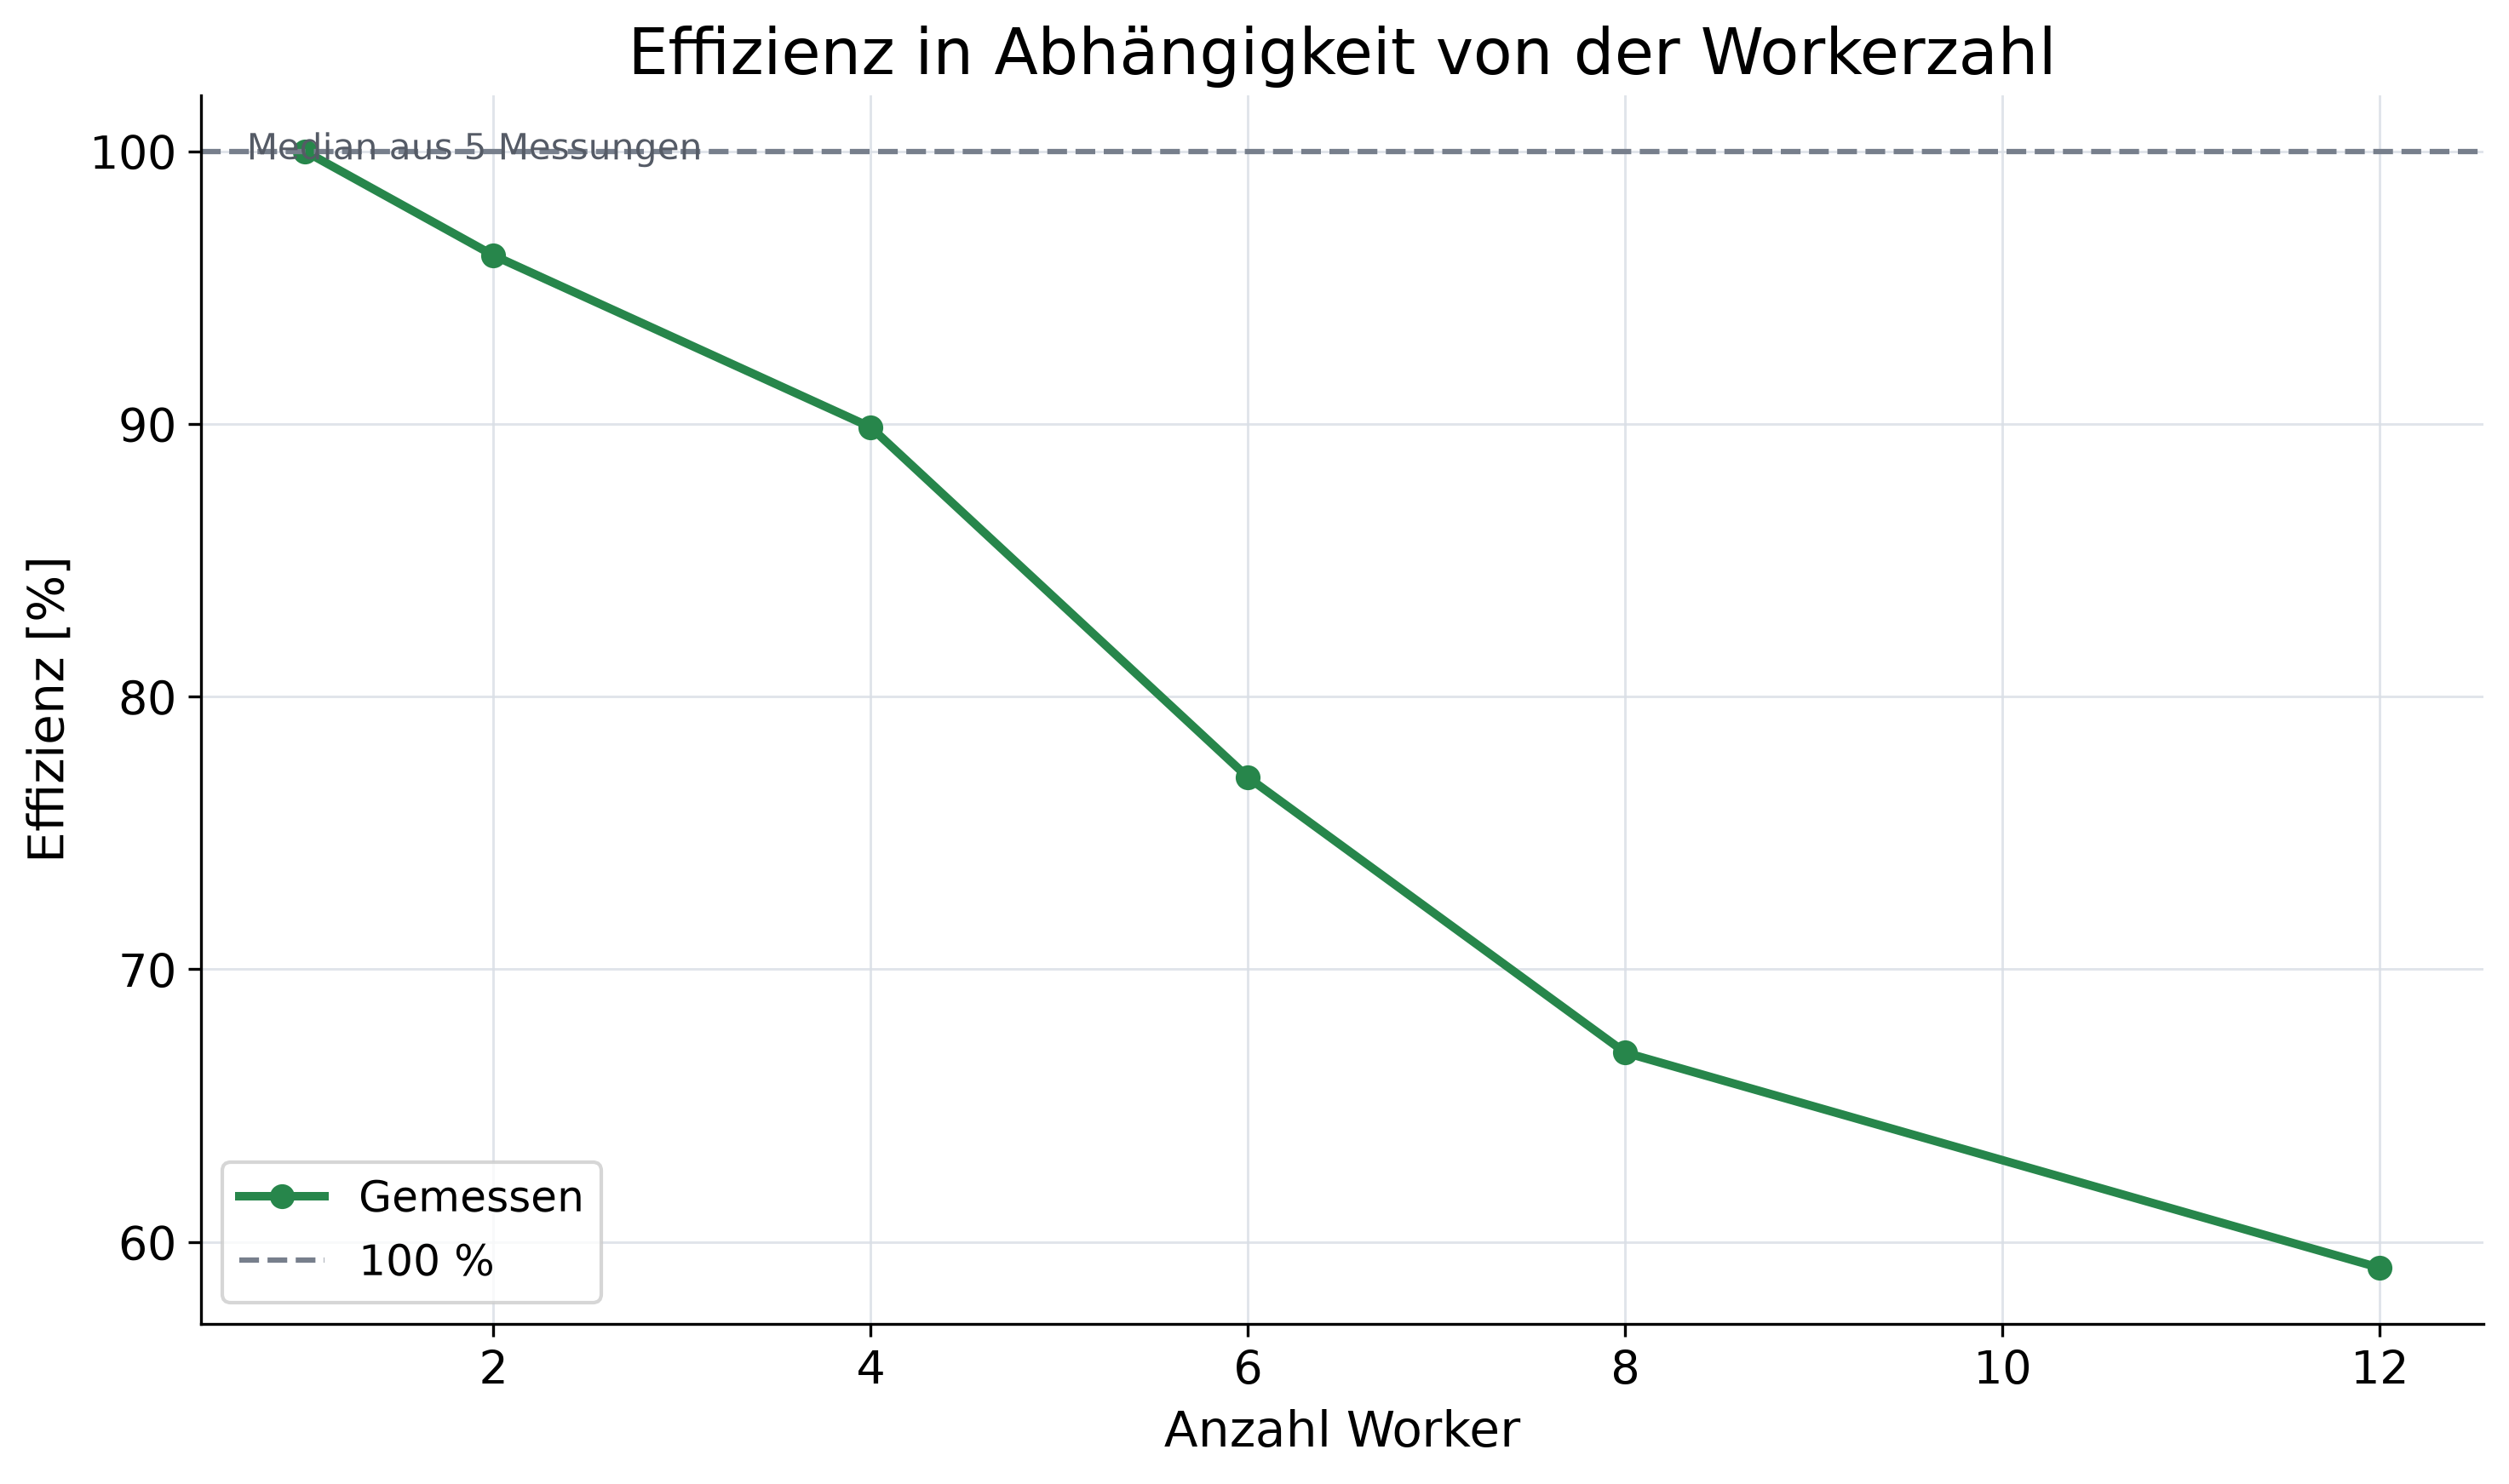
Für zwei Prozesse liegt die Effizienz im Strong-Scaling-Block bei rund 96 Prozent, für vier bei 90 Prozent, für sechs bei 77 Prozent und für acht bei 67 Prozent. Bei zwölf Prozessen sind es ungefähr 59 Prozent. Die Berechnung wird mit jedem Schritt weiter beschleunigt; nur bringt jeder zusätzliche Prozess im Verhältnis weniger Speedup als am Anfang.
Diese 59 Prozent sind keine Aussage über 59 Prozent CPU-Auslastung. Gemessen wurde die Effizienz als Speedup geteilt durch Prozesszahl. Eine CPU-Auslastungsmessung ist etwas anderes und gehört nicht zu diesem Versuch.
Schneller fertig heißt nicht weniger Rechenressourcen
Im selben Strong-Scaling-Block steigen die parallelen Kosten P × T_P von rund 4,06 Prozessor-Sekunden bei der sequentiellen Referenz auf etwa 6,87 bei zwölf Prozessen. Die Antwort kommt viel früher zurück, aber das vereinfachte Kostenmaß zählt mehr parallel bereitgestellte Recheneinheiten über die Laufzeit mit.
Das ist weder eine Messung der Energie noch echte Prozess-CPU-Zeit. Es ist ein theoretisches Vergleichsmaß, das den Zielkonflikt greifbar macht: kürzere Wartezeit kann mit insgesamt höheren parallelen Kosten einhergehen.
Ergebnis 3: große Aufgaben profitieren stärker
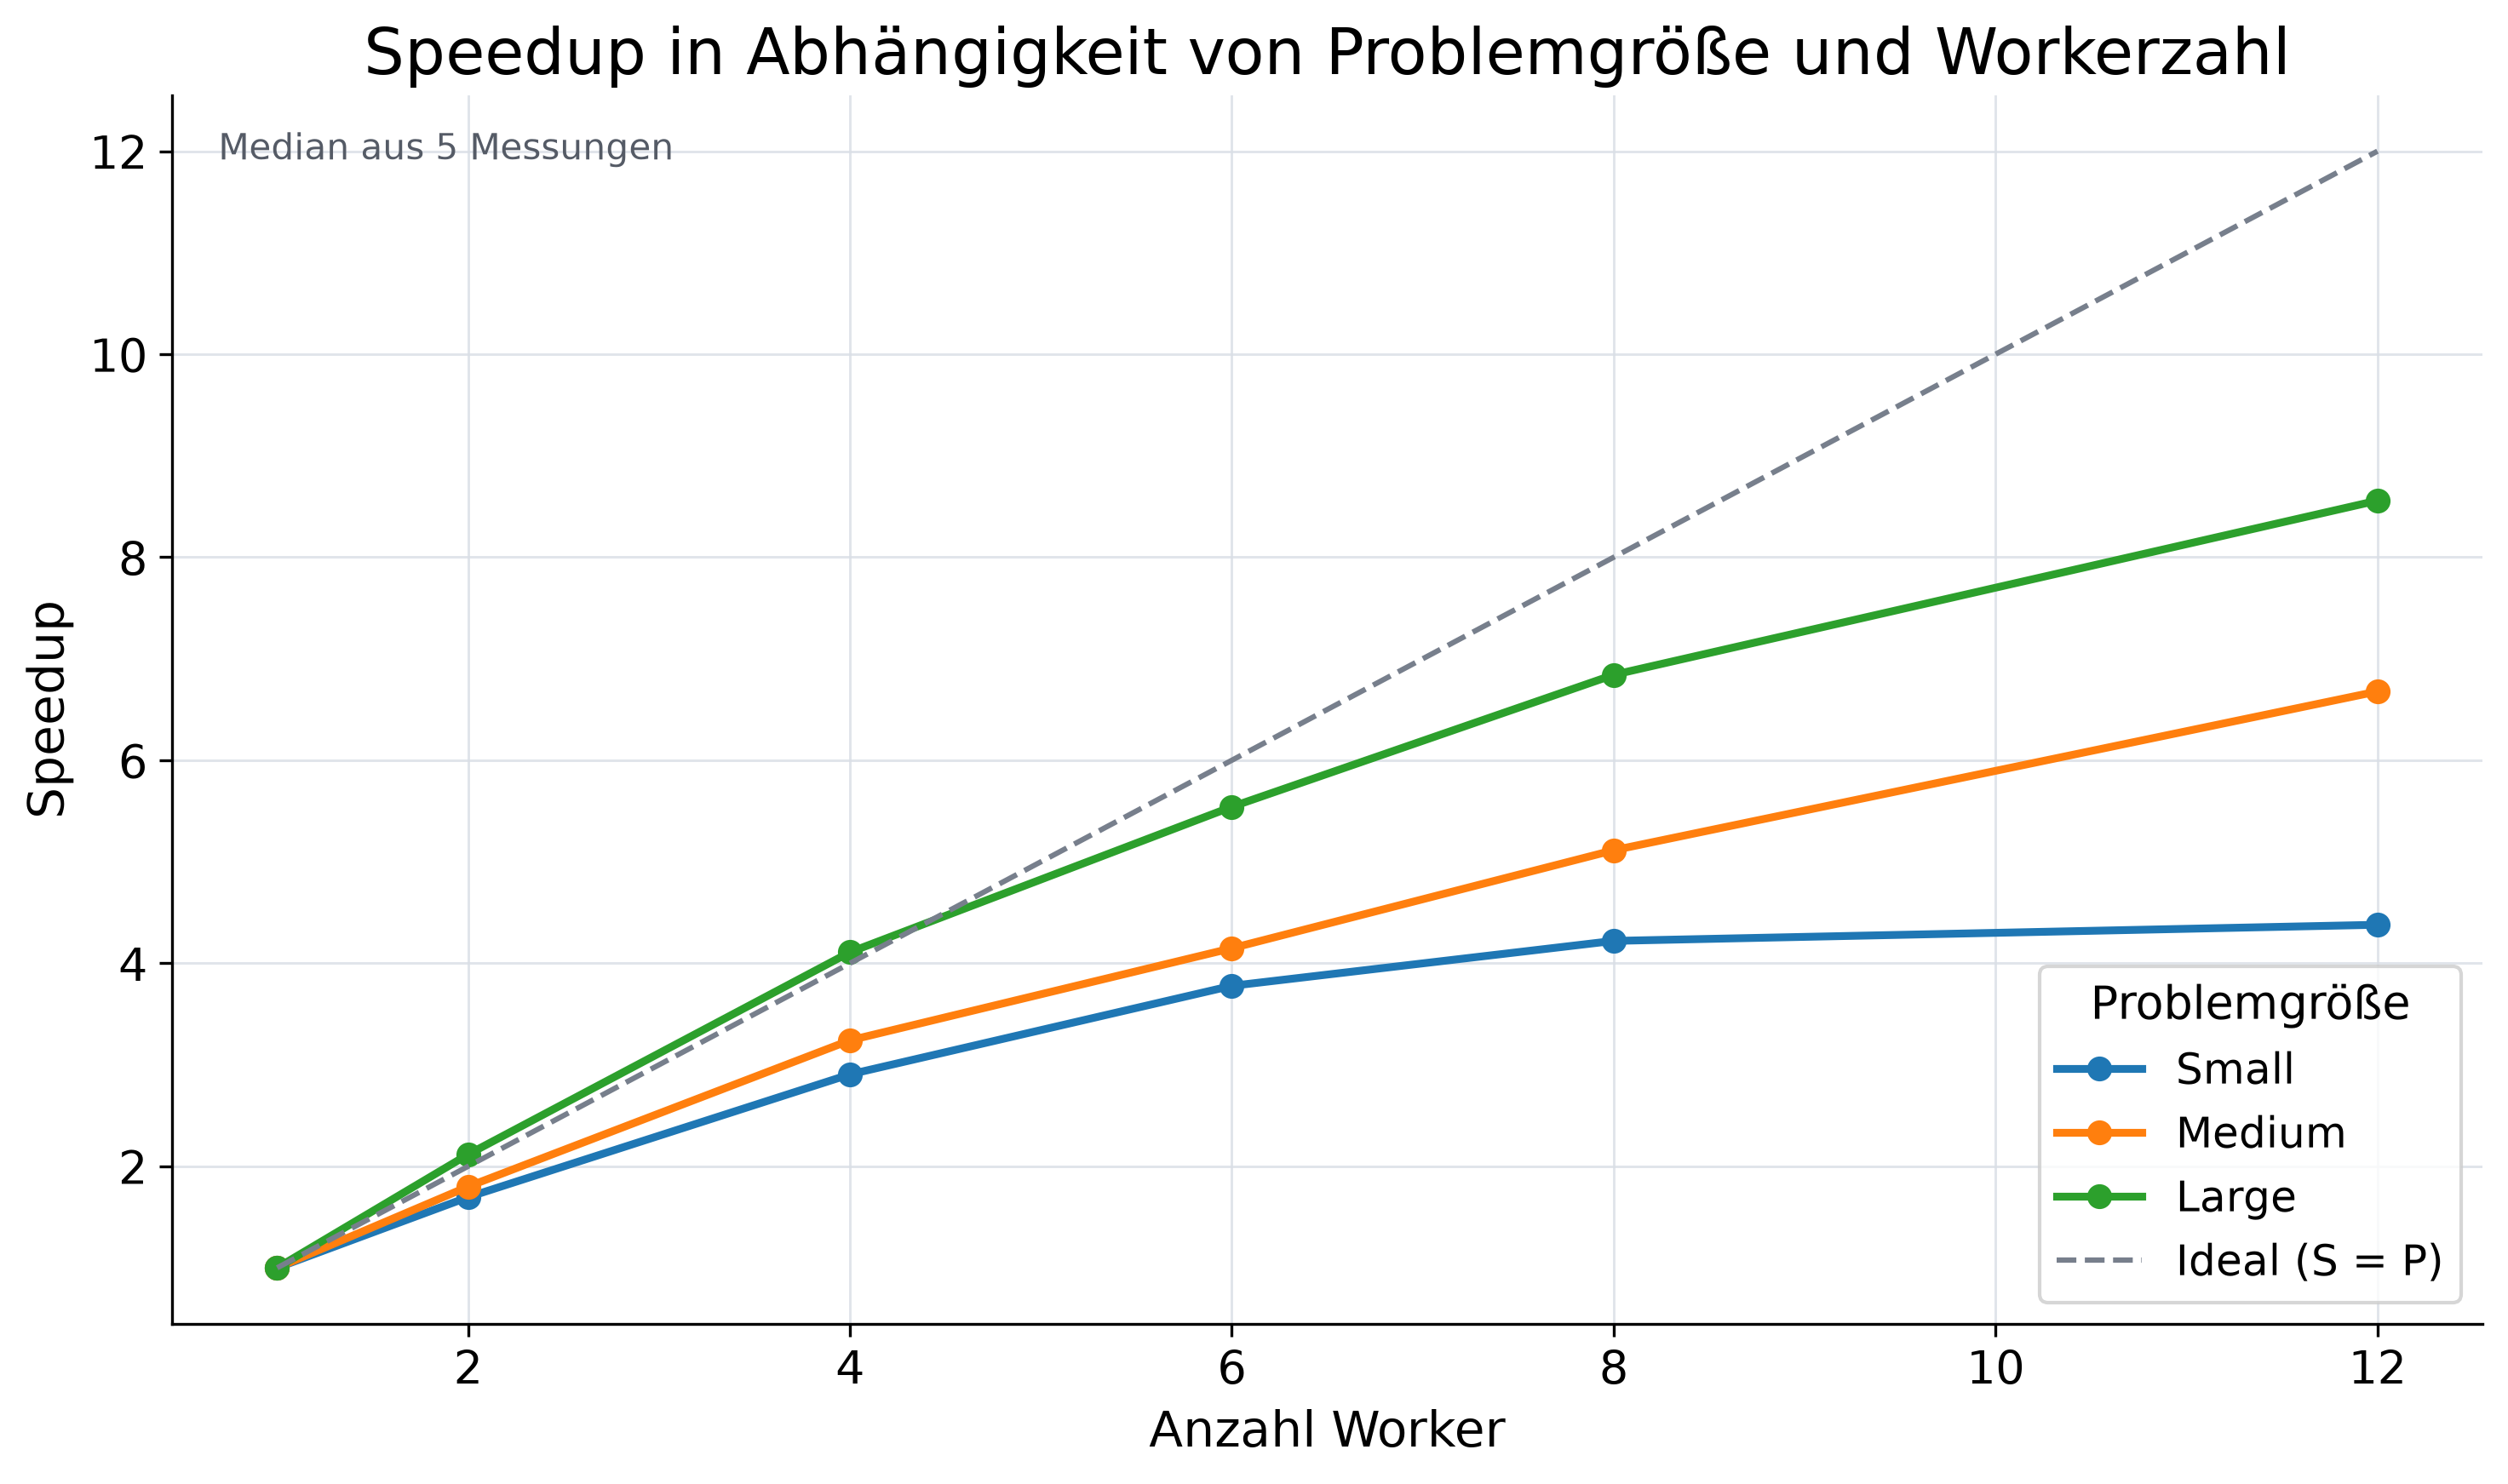
Im separaten Problemgrößenexperiment erreicht die Variante mit zwölf Prozessen für Small einen Speedup von 4,38, für Medium 6,68 und für Large 8,56. Jeder Wert bezieht sich auf die eigene direkte sequentielle Baseline derselben Größe. Diese Speedups sind deshalb nicht mit der Strong-Scaling-Kurve vermischt.
Eine plausible Erklärung: Bei einer größeren Aufgabe fällt die eigentliche Rechenarbeit stärker ins Gewicht; der einmalige Verwaltungs- und Verteilungsaufwand macht relativ weniger aus. Das ist eine Interpretation, keine im Experiment einzeln nachgewiesene Ursache. Gemessen ist zunächst der Unterschied zwischen den drei Größen unter genau diesen Bedingungen.
Ergebnis 4: Speicherbedarf folgt einer anderen Kurve
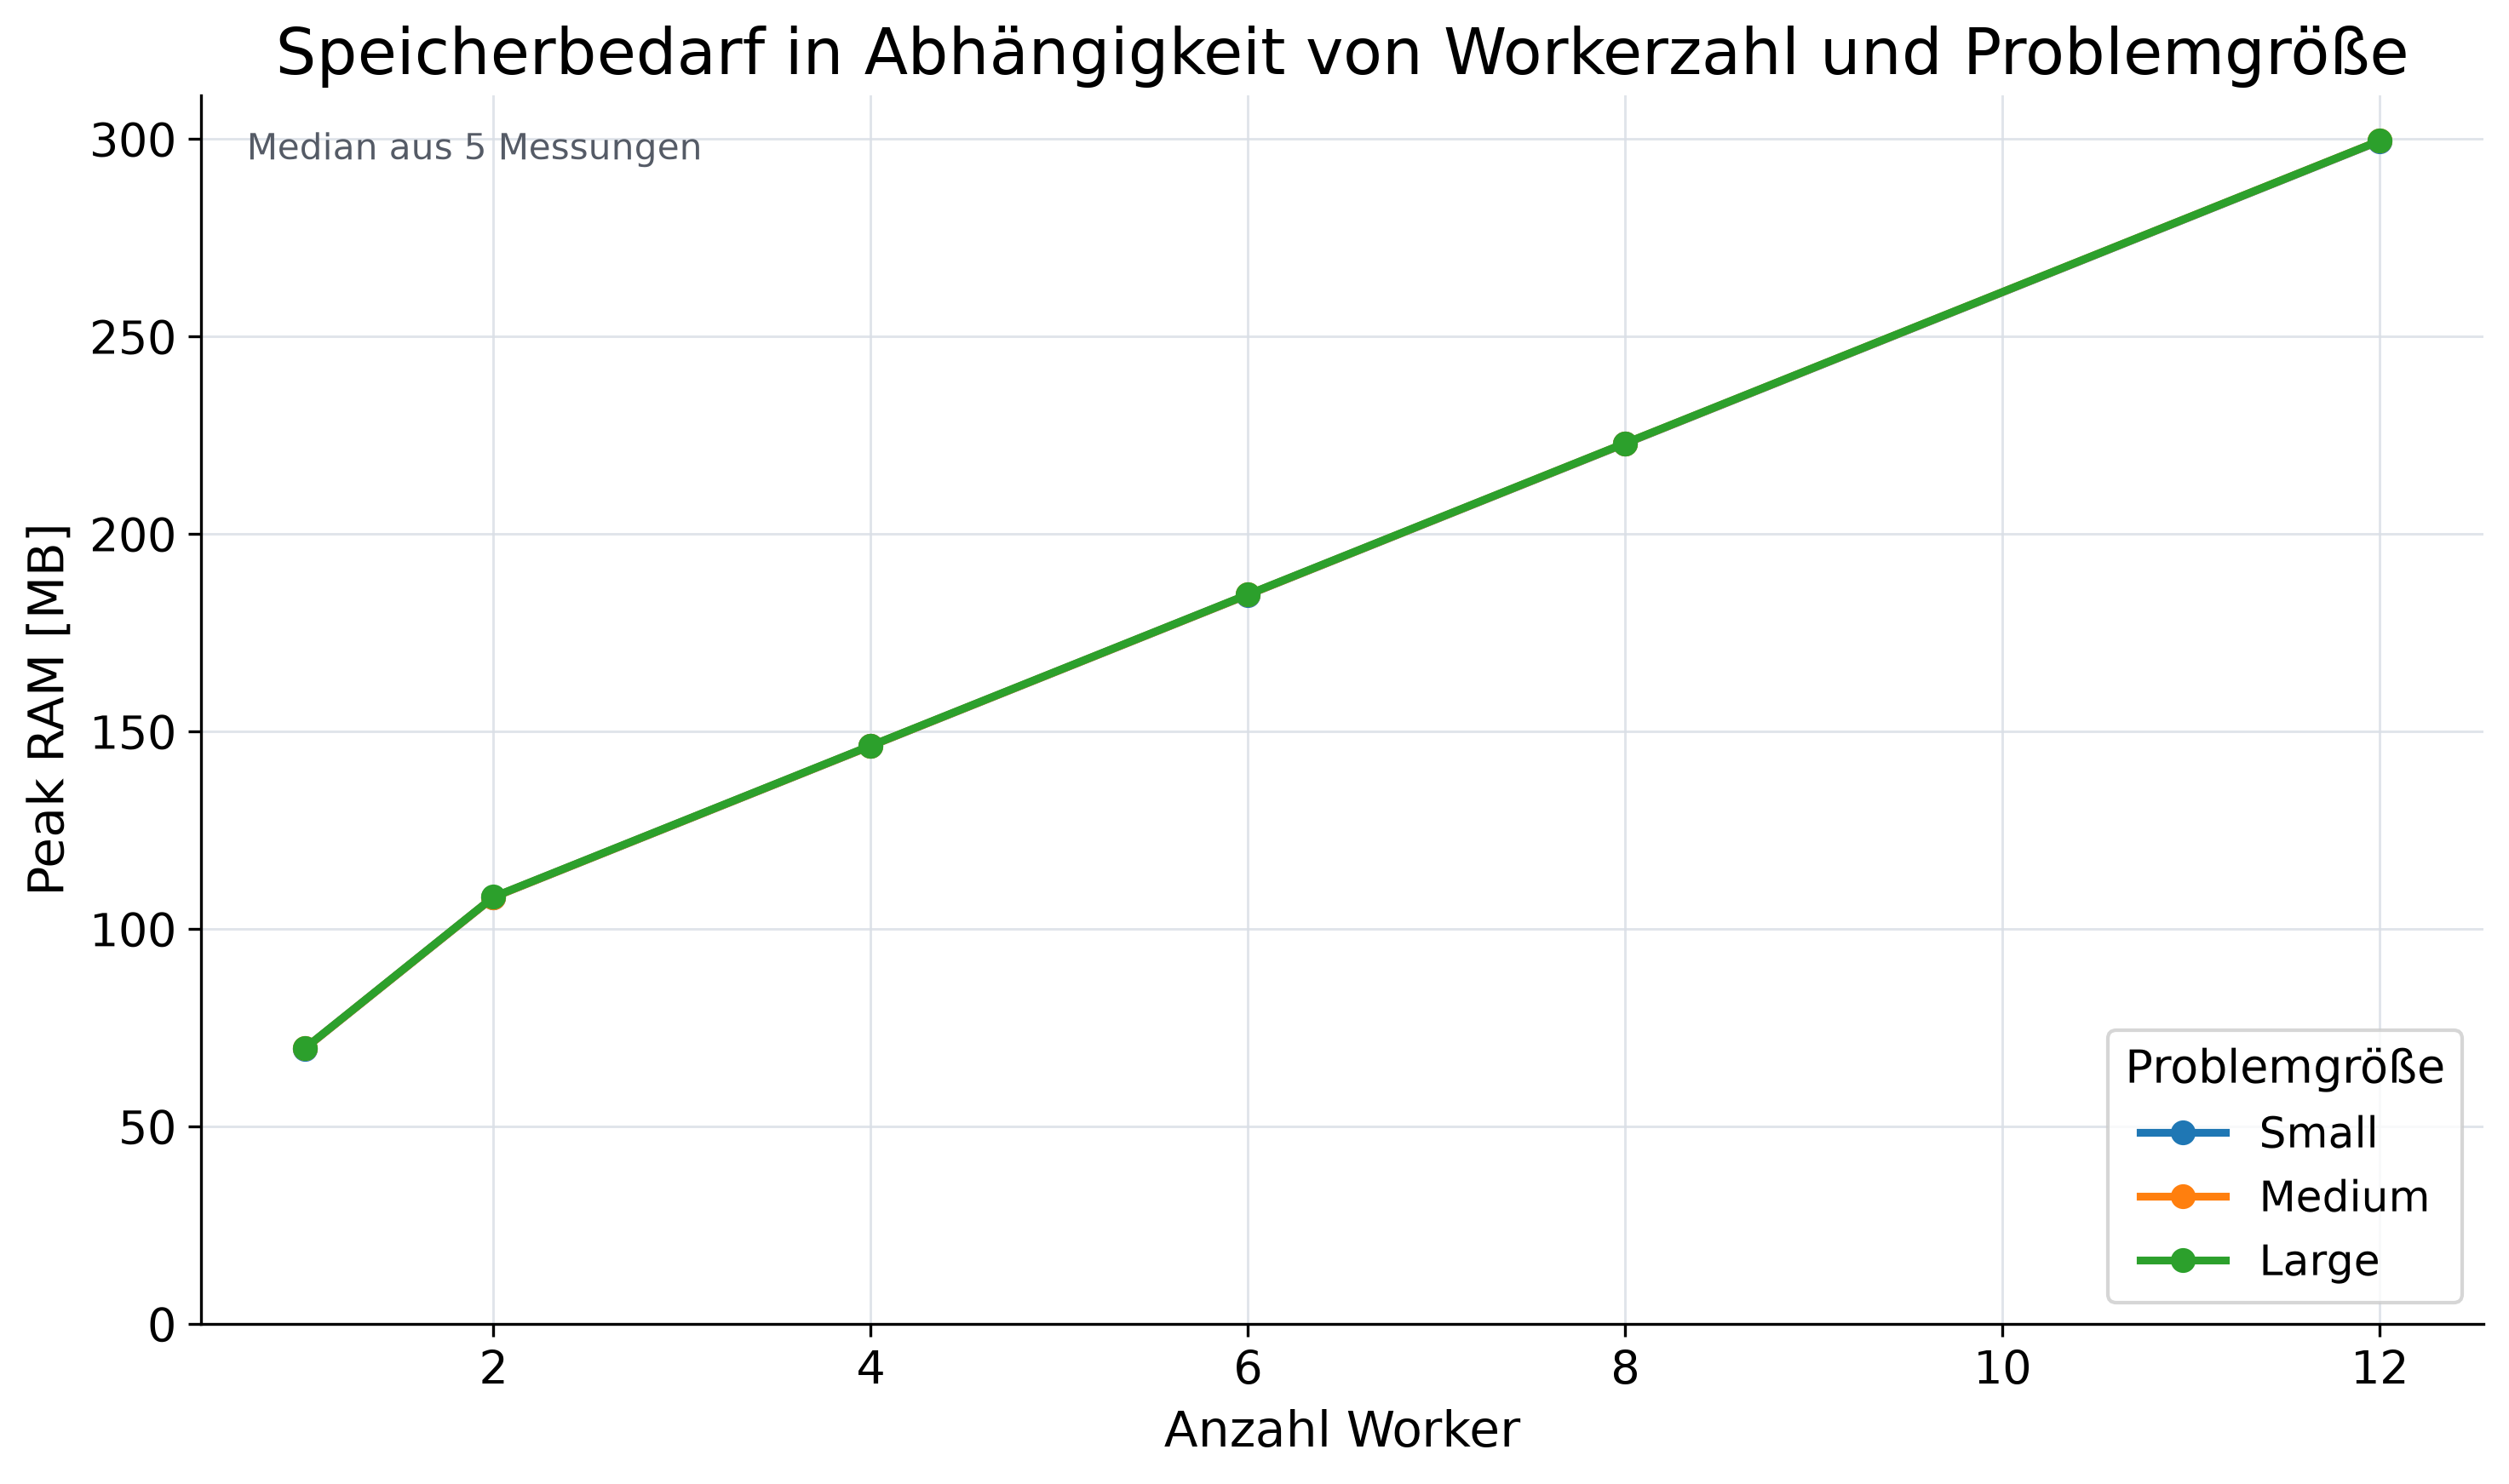
Der beobachtete Peak-RSS liegt im Problemgrößenexperiment für die sequentiellen Läufe bei ungefähr 70 MB. Bei zwölf Prozessen sind es für Small, Medium und Large jeweils etwa 299 bis 300 MB. Die drei Problemgrößen liegen bei gleicher Prozesszahl im Diagramm fast übereinander.
Das passt zur Implementierung: N bestimmt vor allem, wie oft gerechnet wird. Die Zwischenwerte werden nicht gesammelt; jeder Prozess berechnet einen Wert und addiert ihn unmittelbar zu seiner lokalen Summe. Größeres N verlängert hauptsächlich die Rechenzeit, während der zusätzliche Speicher hier vor allem mit weiteren Python-Prozessen, ihren Laufzeitumgebungen und Verwaltungsdaten ansteigt.
RSS bleibt eine Betriebssystem-Näherung. Gemeinsam genutzte Seiten, etwa Bibliotheken, können in den aufsummierten Prozesswerten mehrfach auftauchen. Die Kurve beschreibt also beobachteten Peak-RSS nach der Messmethode des Benchmarks, nicht exakt exklusiv belegten RAM.
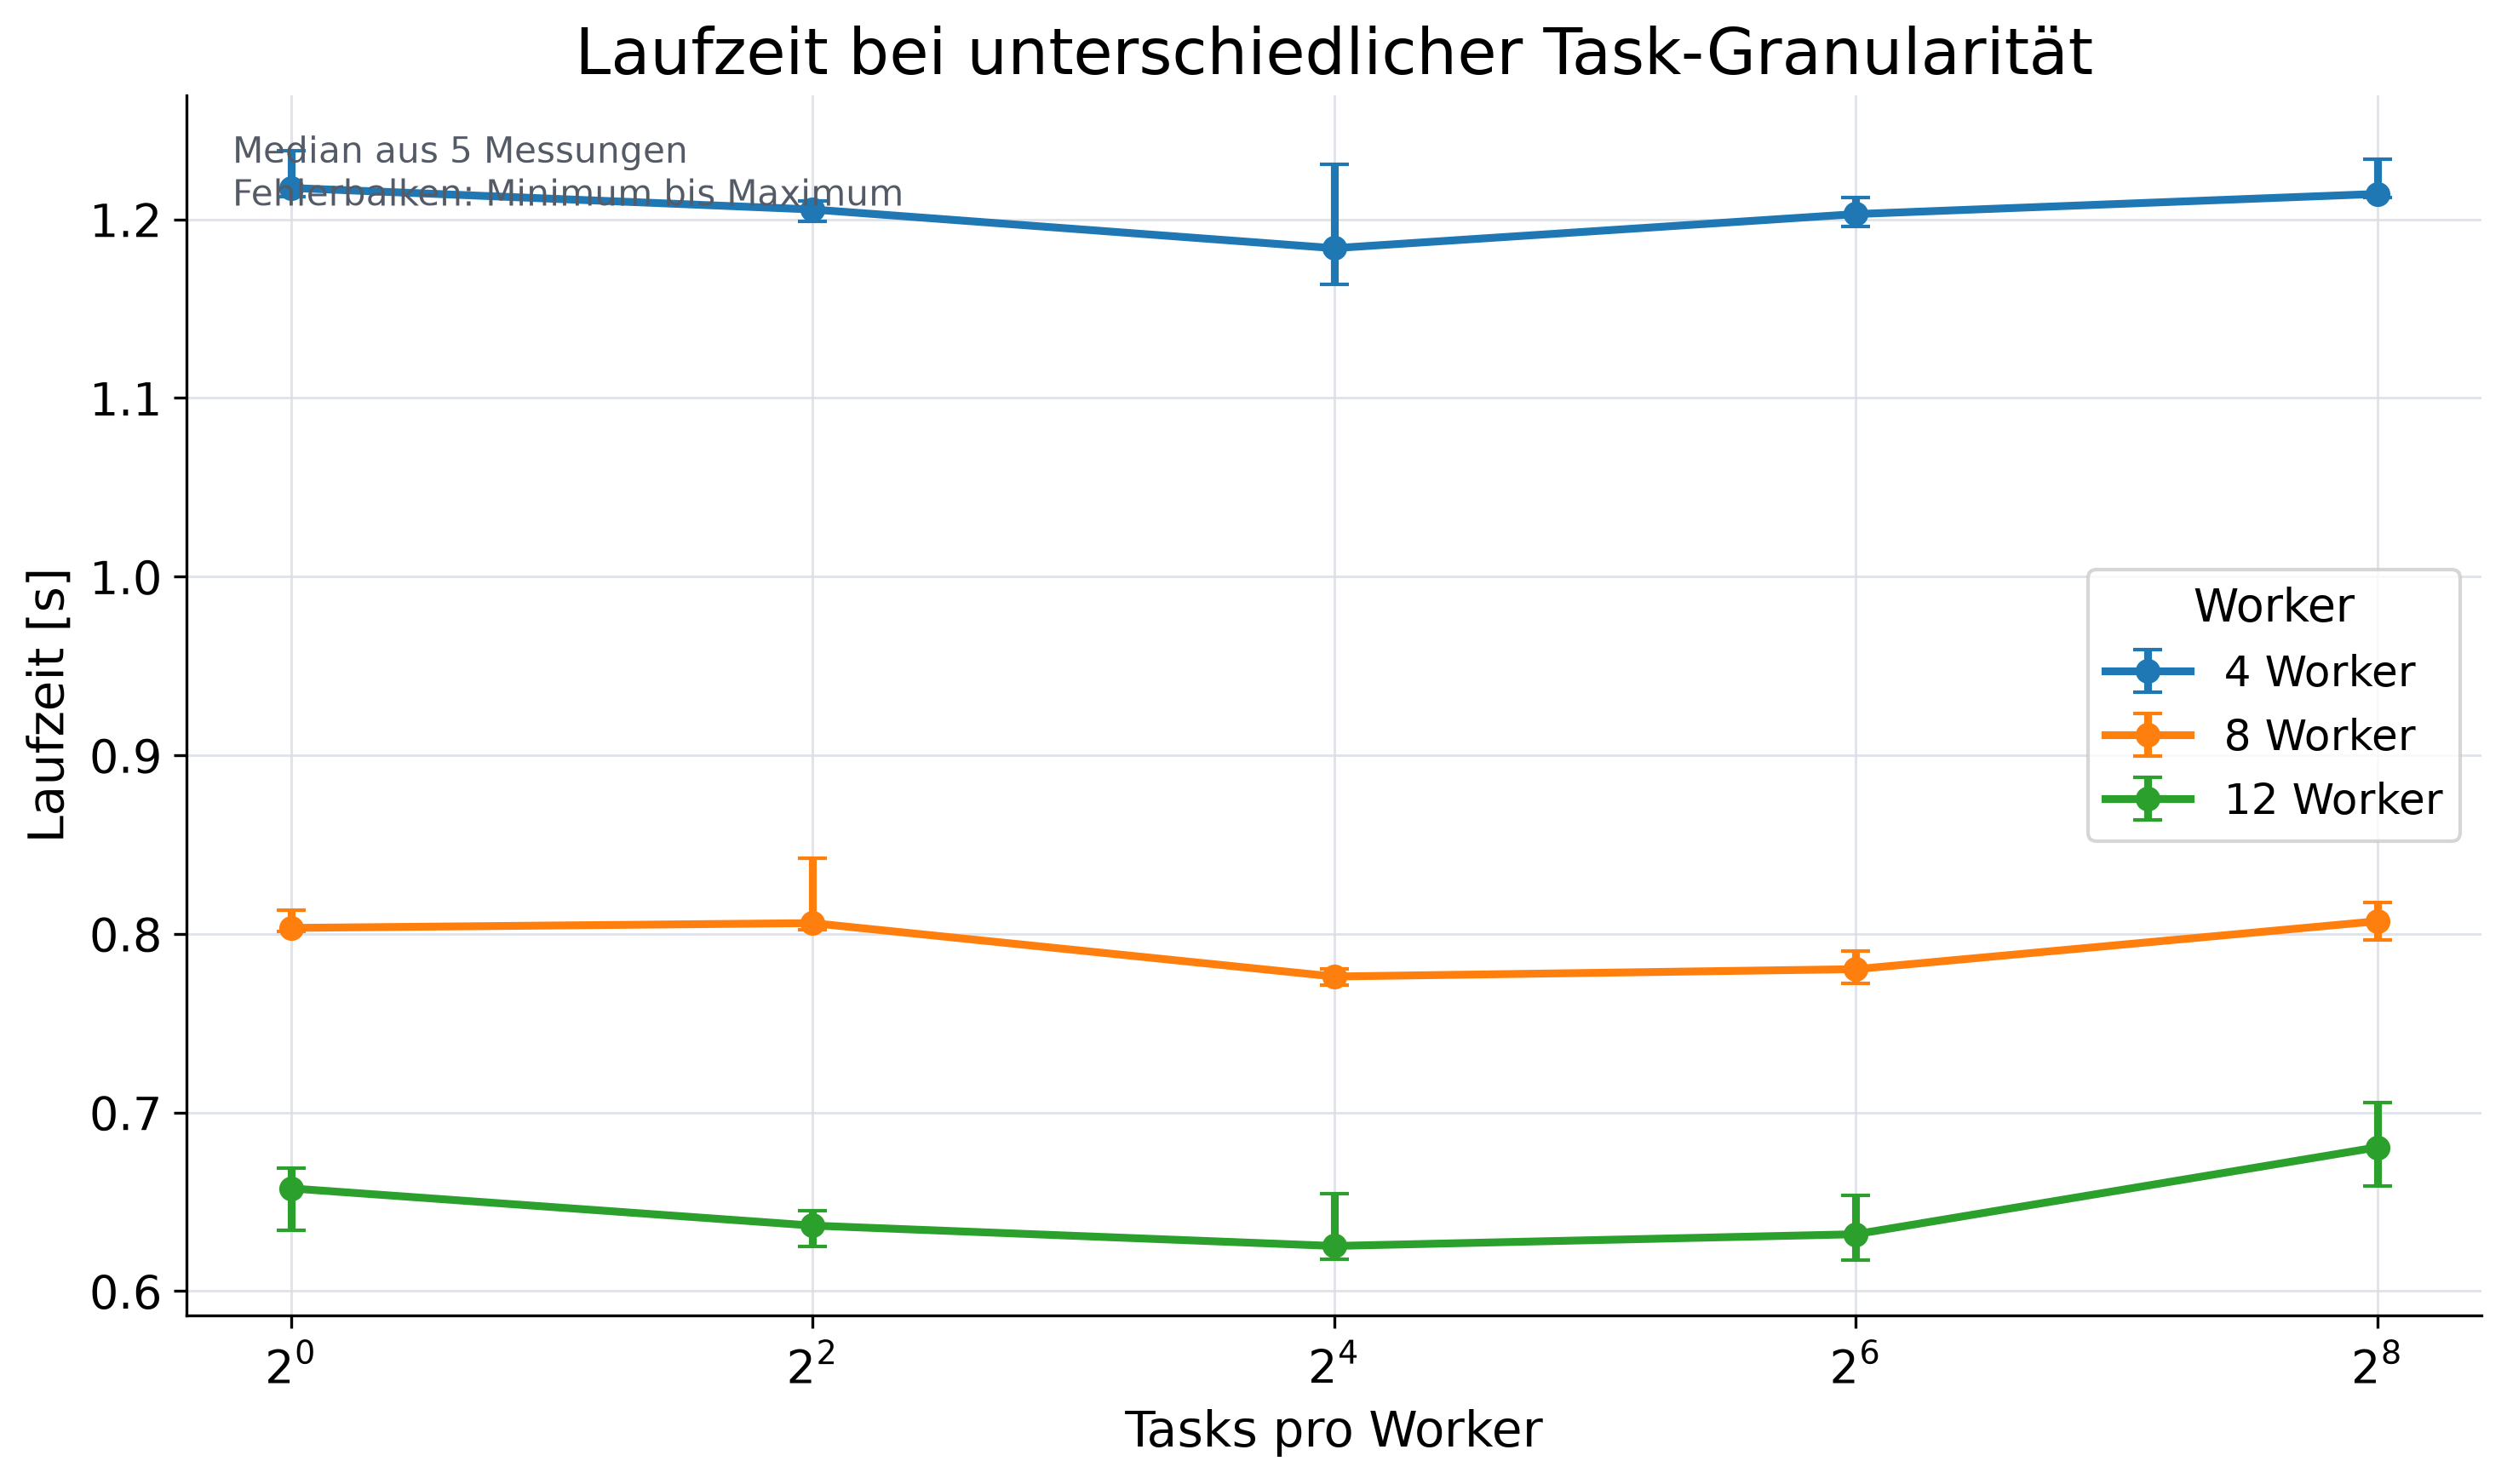
Ergebnis 5: Task-Größe verändert die Laufzeit
Für das Granularitätsexperiment bleibt die Gesamtarbeit gleich. Verändert wird, wie viele Tasks pro Worker entstehen: 1, 4, 16, 64 oder 256. Bei zwölf Prozessen liegen die Medianzeiten bei 0,657 s, 0,637 s, 0,625 s, 0,632 s und 0,680 s.
In diesem Lauf war die Variante mit 16 Tasks pro Prozess etwas schneller als die gröbste und die feinste Aufteilung. Eine gewisse Unterteilung kann unabhängige Bereiche flexibler verteilen. Werden Tasks sehr klein, wachsen Scheduling- und Verwaltungsanteile; werden sie zu groß, kann die Lastverteilung gröber werden. Daraus folgt nicht, dass 16 allgemein optimal wäre – nur, dass Task-Größe in diesem Benchmark messbar war.
Was ich aus dem Versuch mitnehme
Vor dem Experiment war „mehr Kerne“ für mich vor allem eine einfache Rechnung: Arbeit teilen, gleichzeitig rechnen, Zeit sparen. Die Messungen bestätigen den wichtigen Teil davon – die Large-Berechnung wurde viel schneller. Sie zeigen aber auch, was die einfache Rechnung auslässt: Der Speedup blieb unter der Prozesszahl, die Effizienz sank, die RSS-Schätzung stieg und selbst die Aufteilung in Tasks veränderte das Ergebnis.
Die interessantere Frage ist deshalb nicht: „Wie viele Prozesse kann ich starten?“ Sondern: „Wie viel Parallelität ist für genau diese Aufgabe sinnvoll?“ Dafür muss ich Laufzeit, Verwaltung, Speicher und Nutzen nebeneinander betrachten. Parallelisierung ist für mich kein kostenloser Geschwindigkeitsmultiplikator, sondern ein Engineering-Trade-off.
Grenzen des Experiments
Das Ergebnis gilt zunächst für eine CPU-intensive numerische Integration in reinem Python mit ProcessPoolExecutor – nicht automatisch für jeden Algorithmus oder jede Programmiersprache. Der Full-Run dokumentiert als Testsystem einen Intel Core Ultra 5 125H mit Linux und Python 3.14.4. CPU-Affinität wurde nicht erzwungen; Betriebssystem-Scheduler und wechselnde Systemlast bleiben Teil der Messbedingungen.
RSS ist eine zeitlich abgetastete Näherung und kann gemeinsame Speicherseiten mehrfach erfassen. P × T_P ist ein theoretisches Kostenmaß, keine Energie- oder direkte CPU-Zeitmessung. Außerdem schwankten die getrennten Messblöcke; darum verwende ich für jede Reihe ihre eigene sequentielle Baseline. Die größere Frage, warum Chiphersteller nicht beliebig viele Kerne einbauen, beantworte ich damit nicht vollständig: Fertigung, Chipfläche, Energieeffizienz und Wirtschaftlichkeit habe ich nicht untersucht. Mein Benchmark beleuchtet nur, was Software aus zusätzlicher Parallelität herausholt.
Quellen und Code
Die Messwerte, Rohdaten, Konfigurationen und Diagramme stammen aus meinem eigenen Repository. Die drei Links unten stützen die kurze Einordnung von parallelen Algorithmen, der Mittelpunktregel und Python-Prozesspools.